'/%3E%3Cpath fill='%23ffffff' transform='translate(256 256) scale(0.6) translate(-256 -256)' d='M501.1 395.7L384 278.6c-23.1-23.1-57.6-27.6-85.4-13.9L192 158.1V96L64 0 0 64l96 128h62.1l106.6 106.6c-13.6 27.8-9.2 62.3 13.9 85.4l117.1 117.1c14.6 14.6 38.2 14.6 52.7 0l52.7-52.7c14.5-14.6 14.5-38.2 0-52.7zM331.7 225c28.3 0 54.9 11 74.9 31l19.4 19.4c15.8-6.9 30.8-16.5 43.8-29.5 37.1-37.1 49.7-89.3 37.9-136.7-2.2-9-13.5-12.1-20.1-5.5l-74.4 74.4-67.9-11.3L334 98.9l74.4-74.4c6.6-6.6 3.4-17.9-5.7-20.2-47.4-11.7-99.6.9-136.6 37.9-28.5 28.5-41.9 66.1-41.2 103.6l82.1 82.1c8.1-1.9 16.5-2.9 24.7-2.9zm-103.9 82l-56.7-56.7L18.7 402.8c-25 25-25 65.5 0 90.5s65.5 25 90.5 0l123.6-123.6c-7.6-19.9-9.9-41.6-5-62.7zM64 472c-13.2 0-24-10.8-24-24 0-13.3 10.7-24 24-24s24 10.7 24 24c0 13.2-10.7 24-24 24z'/%3E%3C/svg%3E)
Cómo preparar un PDF en Markdown para un flujo RAG
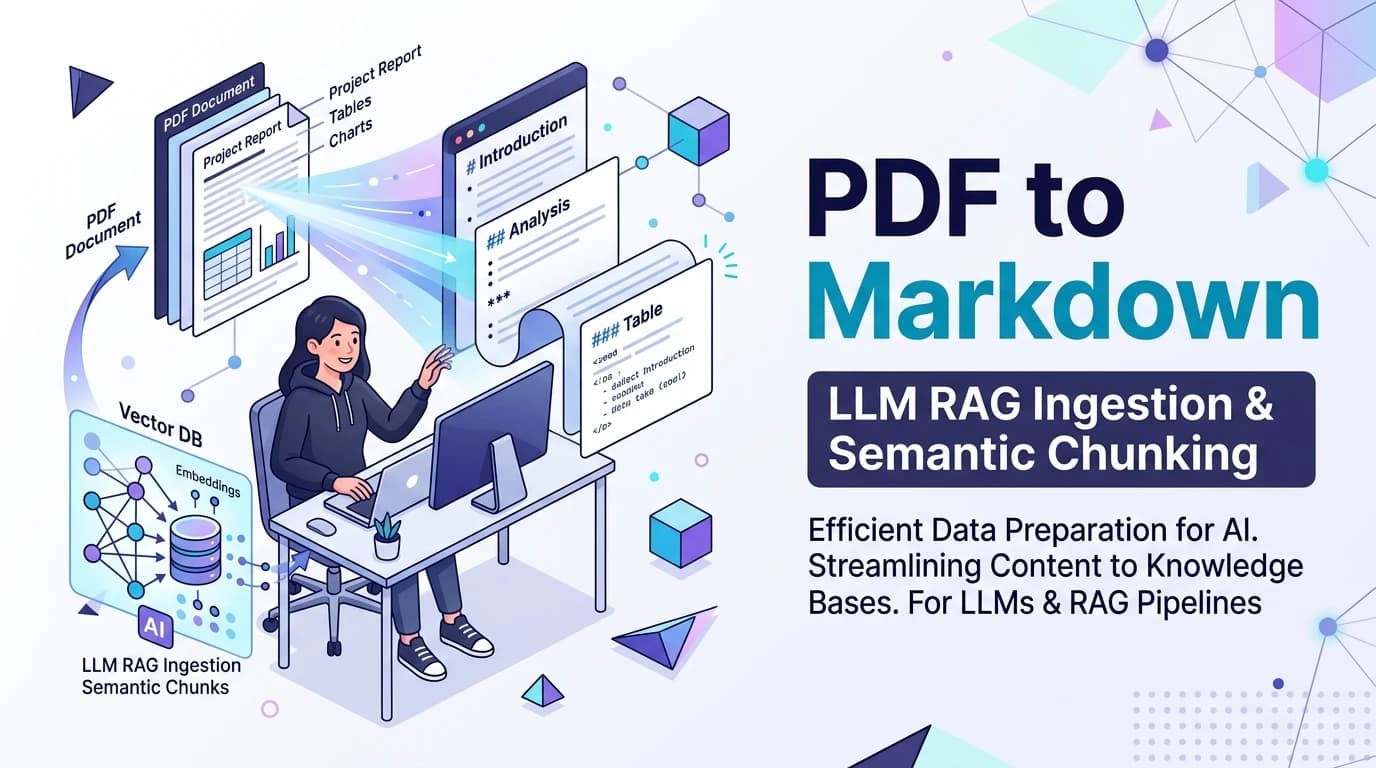
Verifica la extracción antes de indexar
Convierte una muestra a Markdown, comprueba el orden de lectura y conserva la referencia de página. Corrige las tablas que pierdan encabezados antes de alimentar el sistema de búsqueda.
Por qué falla el orden de lectura
El PDF describe posiciones visuales. Un extractor puede mezclar dos columnas, leer notas al pie antes del texto principal o devolver texto vacío en páginas escaneadas.
Trata columnas y tablas de forma explícita
Agrupa texto por región de página. Para tablas, conserva encabezados y unidades junto a los datos. Usa una representación estructurada cuando Markdown no exprese celdas combinadas.
Prepara una conversión reproducible
Extrae el texto seleccionable, aplica OCR cuando haga falta, corrige separaciones de palabras y guarda versión del documento y número de página.
Divide por secciones con contexto
Usa títulos y subtítulos como límites iniciales. Si una sección es demasiado larga, corta en párrafos y conserva la ruta de encabezados en los metadatos.
Recupera fragmentos y amplía con su contexto
Indexa fragmentos pequeños para localizar la evidencia. Recupera también el párrafo o sección que contiene el fragmento cuando se necesite interpretar la respuesta.
Mide con preguntas y referencias verificadas
Crea preguntas sobre cifras, excepciones y conceptos repartidos en varias páginas. Evalúa si se recupera el pasaje correcto y si la respuesta cita la evidencia.
Preguntas frecuentes
¿Convertir a Markdown elimina los errores del modelo?+
Convertir PDF a Markdown
Convierte el texto seleccionable de un PDF en un borrador Markdown. Revisa los encabezados y el orden antes de guardar el archivo.